
Por Marcos Yebra, Marketing y Desarrollo de Negocio en Normadat
Hace tiempo que escribo por aquí y he tenido ocasión de tratar muchos temas relacionados con la tecnología, los procesos y la gestión documental. Hace poco os hablaba sobre esos documentos que creemos que están disponibles, pero a la hora de utilizarlos, no sirven. Ya sea porque damos con una versión antigua, o están incompletos o cualquier otro motivo. Os lo contaba por aquí.
Al final del artículo quedaba en el aire una cuestión a la que merece la pena volver. Qué ocurre cuando quien tiene que utilizar esa documentación es un sistema de inteligencia artificial.
La IA ha avanzado por todos los terrenos. Por supuesto ha llegado también a los archivos. Ahora podemos preguntar en lenguaje natural lo que antes teníamos que buscar en los índices o inventarios.
Esa facilidad a la hora de encontrar una respuesta válida, perfecta, puede hacernos olvidar todo el trabajo que hay detrás. Y, aunque no caigamos en la cuenta, alguien ha tenido que ocuparse antes de ordenar y clasificar la documentación.
En un archivo tradicional, a pesar de que todos sus fondos estén digitalizados, localizar una referencia dentro de cientos de expedientes puede seguir exigiendo muchas horas de lectura. Quizá la referencia que buscamos nunca se recogió en la descripción. O aparece con una expresión distinta de la que se nos ha ocurrido buscar. Y ahora, como por arte de magia, aparece ante nosotros. La IA tiene un gran potencial, es cierto. Pero antes de tirar los cohetes haremos un ejercicio previo: conocer como esa información tan precisa ha podido llegar ante nosotros.
Conocer el archivo que vamos a consultar
Los archiveros, cuando describen un fondo, llegan a conocerlo bien. Saben sobre él bastante más que simplemente los documentos que contiene. Saben quién los produjo, para qué, cómo se agrupan, qué periodos abarcan y qué relaciones mantienen.
Ese conocimiento tiene consecuencias muy prácticas. Organiza y clasifica la información. Permite discernir qué queremos recuperar, qué documentación necesitamos y dónde pueden aparecer dificultades.
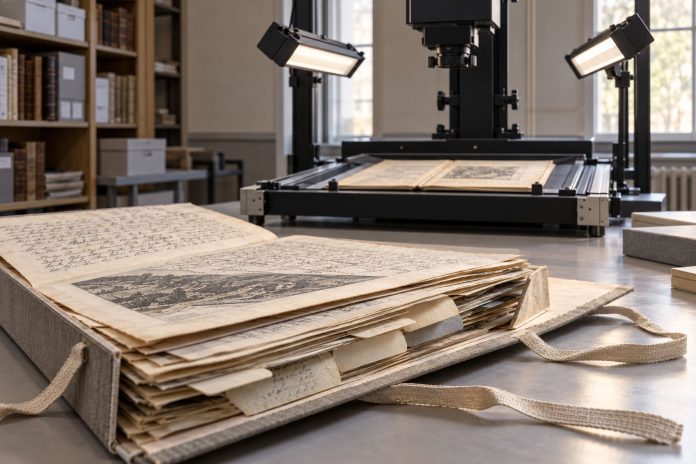
Los profesionales del archivo hacen accesible la documentación mediante cuadros de clasificación, inventarios, catálogos e índices. Ese trabajo de descripción recoge contenido, procedencia y relaciones que orientan la consulta. Y conviene no perderlo, ya que es muy útil cuando incorporamos otras formas de recuperación.
Los metadatos también condicionan la respuesta
Ahora podemos recuperar información mediante lenguaje natural. Podemos dar con una referencia en el cuerpo de un informe, aunque no forme parte de la ficha de descripción. Y ya no es necesario siquiera utilizar los mismos términos que aparecen el documento. Ahora bien, no podemos olvidar que, esa referencia pertenece a un documento, tiene una fecha y forma parte de un contexto determinado. Conviene que el sistema conserve esa información.
Con un ejemplo se entiende mejor. Queremos saber el procedimiento para tramitar una reclamación, pero en el archivo hay instrucciones de varios años, un borrador y un procedimiento aprobado que sustituyó al anterior. Todos hablan de reclamaciones.
Para responder no basta con localizar información sobre reclamaciones, necesitamos saber cuál es exactamente la que corresponde al momento y al caso que estamos consultando.
Aquí los metadatos entran en juego. Si registramos y mantenemos correctamente el estado, las fechas de vigencia o la relación entre versiones, podemos configurar la recuperación para acotar las fuentes adecuadas. La semejanza semántica ayuda a encontrar contenidos relacionados; los metadatos nos posibilitan discriminar cuales son pertinentes para esa consulta concreta. Es decir, nos permiten introducir condiciones que la semejanza por sí sola no resuelve. Por eso no basta con conservar el contenido, el contexto documental juega un papel muy relevante durante la recuperación.
Esto resulta especialmente relevante en los sistemas RAG, ya que lo que ocurre en la recuperación de contenidos tiene mucho peso. Si faltan los pasajes necesarios, o llegan otros que corresponden a un caso diferente, el modelo trabajará con un contexto insuficiente o inadecuado.
Pero seleccionar las fuentes adecuadas no es el único factor. La preparación de estos contenidos importa más de lo que parece. Estos sistemas suelen dividir los documentos en fragmentos para recuperarlos. La longitud y la forma de hacer esos cortes afectan al contexto disponible.
Por eso la preparación de un archivo para IA requiere conversación entre quienes conocen la documentación y quienes configuran la solución. Después tocará probar si las consultas recuperan lo que deberían.
Cada fondo pide su tratamiento
Además, bajo la etiqueta de IA estamos agrupando tareas bastante distintas. Reconocer escritura, clasificar expedientes, extraer campos o generar una respuesta requieren tratamientos que pueden combinarse, según la documentación con la que trabajamos y el resultado que buscamos.
The National Archives del Reino Unido evaluó cinco soluciones de IA para ayudar en la selección de documentos digitales destinados a conservación permanente. Ninguna destacó de forma constante en todas las tareas. Los mejores resultados se encontraron cuando se preparaban cuidadosamente los datos de entrenamiento y se probaban y ajustaban los modelos.
Era un proyecto de selección documental, no de consultas con IA generativa, pero sirve para acercarnos al trabajo que supone aplicar estas tecnologías a un archivo. Entre sus conclusiones se daba un papel esencial al conocimiento de los profesionales responsables de los documentos, que son quienes conocen el fondo y pueden valorar si el resultado tiene sentido.
Buena parte de ese trabajo ya forma parte de la gestión documental. Los metadatos, las responsabilidades y los controles sobre los documentos aparecen, por ejemplo, en el alcance de ISO 15489-1. Al incorporar IA podemos apoyarnos en ese trabajo para definir qué documentación se podrá consultar, conservar su contexto y establecer las condiciones de acceso.
Y tendremos que comprobar las respuestas. Un archivo organizado ayuda a recuperar información pertinente, aunque una arquitectura RAG puede seguir equivocándose. Los enlaces a las fuentes nos permiten volver a los documentos y revisar si sostienen lo que el sistema ha respondido, especialmente cuando vamos a tomar una decisión con esa información. Puede que, después de tanto esfuerzo para conseguir que una máquina nos responda, una de las cosas más útiles que nos enseñe sea a preguntar mejor a nuestros propios archivos.